你有没有遇到过这样的情况
每次要和 AI 开始一段对话之前,人先卡在了第一步:这个任务,到底该选哪个模型?
用 A 模型,会不会太贵?换 B 模型,又怕不够聪明。C 模型看起来便宜,可它真能搞定这个任务吗?
对个人,这只是一次选择困难;对企业,这是每天都在发生的一笔糊涂账:
80% 的请求只是写邮件、整理纪要,却被一路送进了最贵的模型;
研发随手把一段核心代码粘进公网对话框,数据出了厂谁也说不清;
五六个模型平台账单,对不上、拆不开、管不住;
某个模型半夜限流,第二天早上才发现整条业务线停了半小时。
于是越来越多企业开始做同一件事:把散落在各部门的 AI 调用,收口到一个统一入口——AMAX AI Gateway 企业级 AI 模型网关,就是这样的产品。一个入口纳管 70+ 主流大模型与企业私有化模型,统一接入、统一鉴权、统一配额、统一审计、统一路由。
01 问题:多模型时代,「选谁」成了新成本
但网关刚把模型接齐,下一个问题立刻浮出水面:
后面挂着几十个模型,用户这句请求,到底该交给哪一个?
"该用谁"本身,正在成为新的成本中心。
最直觉的做法,是再叫一个 LLM 来当裁判:让它读完每个模型/专家的能力边界,输出一个类别,再据此路由。这就是常见的LLM Judge方案。它足够聪明,但在私有化部署的场景里,但代价也很实在:
·成本叠加:每条请求都要多花一次 LLM 调用,延迟叠加、按量计费;
· 不稳定因素:判断依赖上游服务的可用性与配额,多了一层不稳定;
· 隐私面变大:用户的原始请求要出网关去判一次意图,隐私面变大。
第三点是最致命的。
一家制造企业上了本地化部署的 AMAX AI Gateway,生产数据、工艺参数、经营报表全程内网闭环、不出厂区——结果为了判一句"这句话该给哪个模型",原始 Prompt 先发去了公有云。私有化做了 99 分,最后 1 公里漏了。
对我们服务的政企、金融、医疗、高端制造客户来说,这不是可以妥协的选项。合规对标等保 2.0,审计要能回答"谁在什么时间、用了什么模型、传了什么类型的数据"这就是为什么这道判断题,必须在企业私有化网关里完成。
所以我们给自己定的目标很明确:能不能让网关自己、在本地、在几十毫秒内就把意图判出来?不调用外部 API,不占用任何外部额度,不让一个字节出网。
02 AMAX AI Gateway 的意图识别,在做什么
AMAX AI Gateway 的意图识别(Expert Routing)是一条固定链路:
用户请求 → 信号预处理 → 意图分类器 → 命中专家 → 路由到对应模型
网关预置了一整套「专家团」,按6 大业务场景 × 4 类意图组织——覆盖编码、客服、知识库、文案、数据分析、翻译。分类器要做的,就是从用户那句自然语言里,读懂它属于哪一个专家,再把请求交给对应的模型通道。
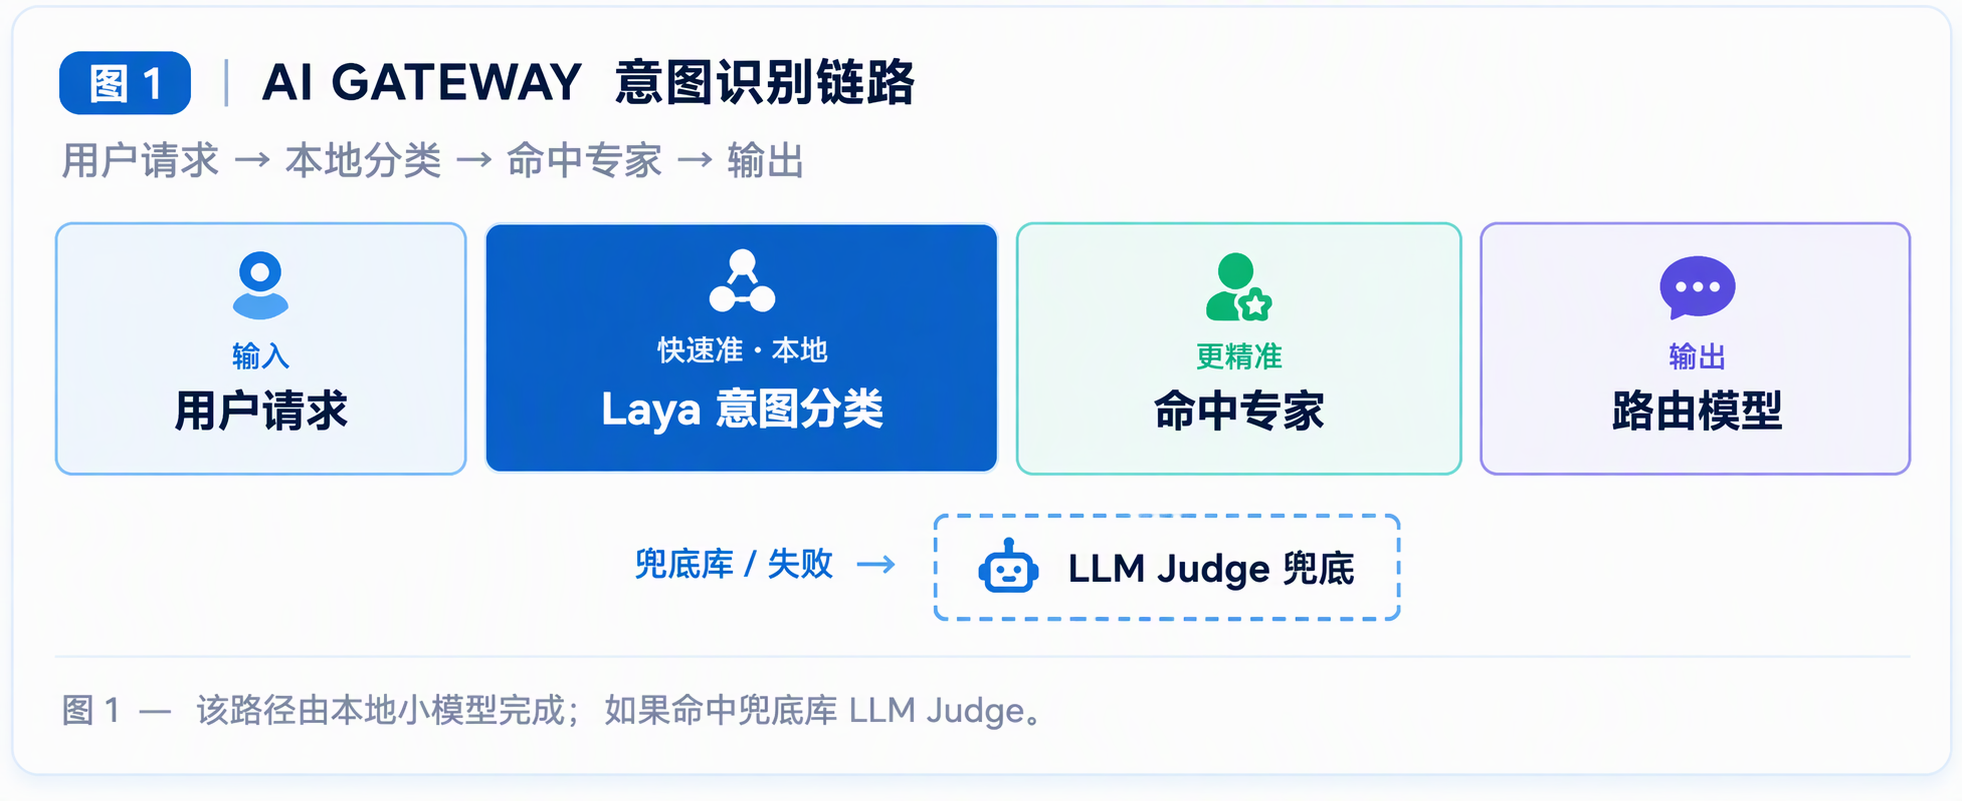
在 AMAX AI Gateway 的整体架构里,它和统一接入、智能调度、权限与配额管理、观测与日志审计、合规防护一起,构成企业级 AI 治理的闭环。
03 新做法:本地小模型做「快路径」
我们引入了Laya——一个非自回归的决策模型:给定一段文本和一组结构化问题,它一次前向就返回带概率的答案,不需要逐字生成。
我们选用其中支持中文的multilingual 版本(322M,mmBERT 底座),并把它导出为动态 shape 的 ONNX、量化成 int8,直接跑在网关所在机器的 CPU 上。不依赖 GPU,也不依赖任何外部 API。
于是路由变成两层:
快速路径:本地模型先做快判,高置信直接命中专家;
兜底路径:低置信或失败,再交给 LLM Judge。
既快,又不牺牲兜底能力。
对私有化客户,这个设计还有一层额外价值:它不需要为路由判断预留 GPU。纯软件部署在现有 8 核 16G 服务器上就能跑,一体机形态插电即用;在 AMAX 液冷智算底座、AI 一体机,以及已完成昇腾适配的国产化算力环境里,同样可以直接落地。
04 实测:本地推理有多快
测试环境:16 逻辑核 CPU,无 GPU。同一个模型,三种运行方式对比:
| 方案 | 磁盘 | 加载 | 内存 | 延迟 | 吞吐 |
|---|---|---|---|---|---|
| torch fp32 | 614MB | 27–33s | ~1.3GB | 286ms | 3.7–4.3/s |
| ONNX fp32 | 1.23GB | 2.5s | ~543MB | 379ms | 3.5–3.9/s |
| ONNX int8 | 309MB | 0.9s | ~379MB | 246ms | 5.9–6.3/s |
单位:单次 24 路意图判定的延迟(p50)。int8 让模型磁盘小 3.5×、加载快约 30×、内存省约 3.4×、延迟再降约 20%。
它也对输入长度很「线性」:约1.1ms / token,短请求 268 token 只需290ms,长请求 619 token 约720ms——延迟可预测,不会像 LLM 那样忽快忽慢。这一点对网关尤其关键:路由层的抖动会直接放大到下游全链路。
05 实测:准确率,以及一个决定性的发现
我们先按「6 场景 × 4 档位」的旧专家团测。给定正确场景后判断 4 个复杂度档位,结果停在36.1%。混淆矩阵揭示了原因:模型几乎退化成了一个「常数预测器」——72 条样本里62 条被预测为 simple。
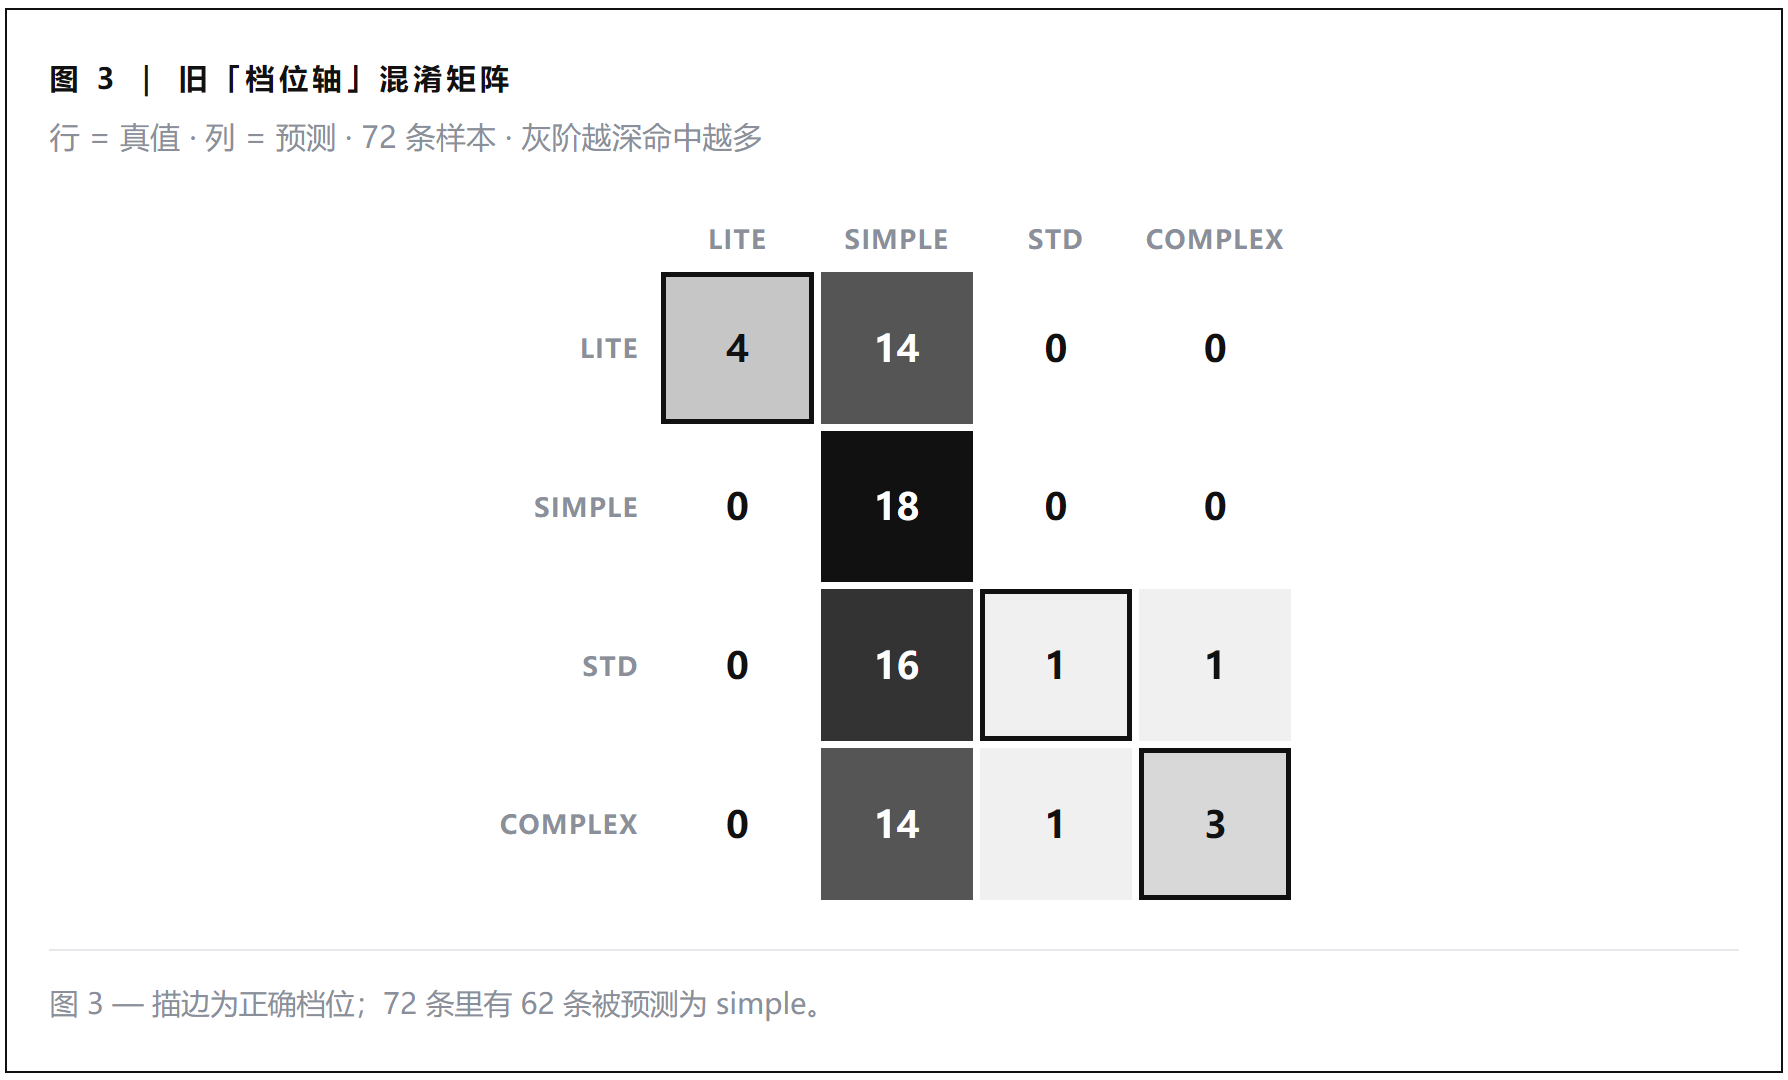
原因并不在模型,而在分类法本身。
档位不是请求文本的属性,而是「该花多大力气」的决策。
「lite / simple / standard / complex」描述的是投入,文字里并没有这条线索,模型自然学不到。
于是我们做了一次分类法重构:把专家的主轴从「努力档位」换成「语义任务类型」——同样 6 场景、同样 24 个专家,只改了分类的轴。
| 场景 | 4 类语义意图 |
|---|---|
| 编码 | 生成代码 · 解释代码 · 排错修复 · 重构评审 |
| 客服 | 寒暄应答 · 咨询查询 · 业务办理 · 投诉纠纷 |
| 知识库 | 单点查证 · 归纳整理 · 对比差异 · 合规判断 |
| 文案 | 短文案 · 通知公告 · 营销推广 · 创意策划 |
| 数据分析 | 口径解释 · 取数 SQL · 报表解读 · 归因洞察 |
| 翻译 | 词句直译 · 通用翻译 · 专业翻译 · 本地化润色 |
同一个模型、同一批样本,只换了分类的轴,结果立刻不同:
| 指标 | 旧:复杂度档位 | 新:语义任务类型 |
|---|---|---|
| 给定场景,4 路意图 | 36.1% | 75.0% |
| 端到端 24 路路由 | ~27% | 48.6% |
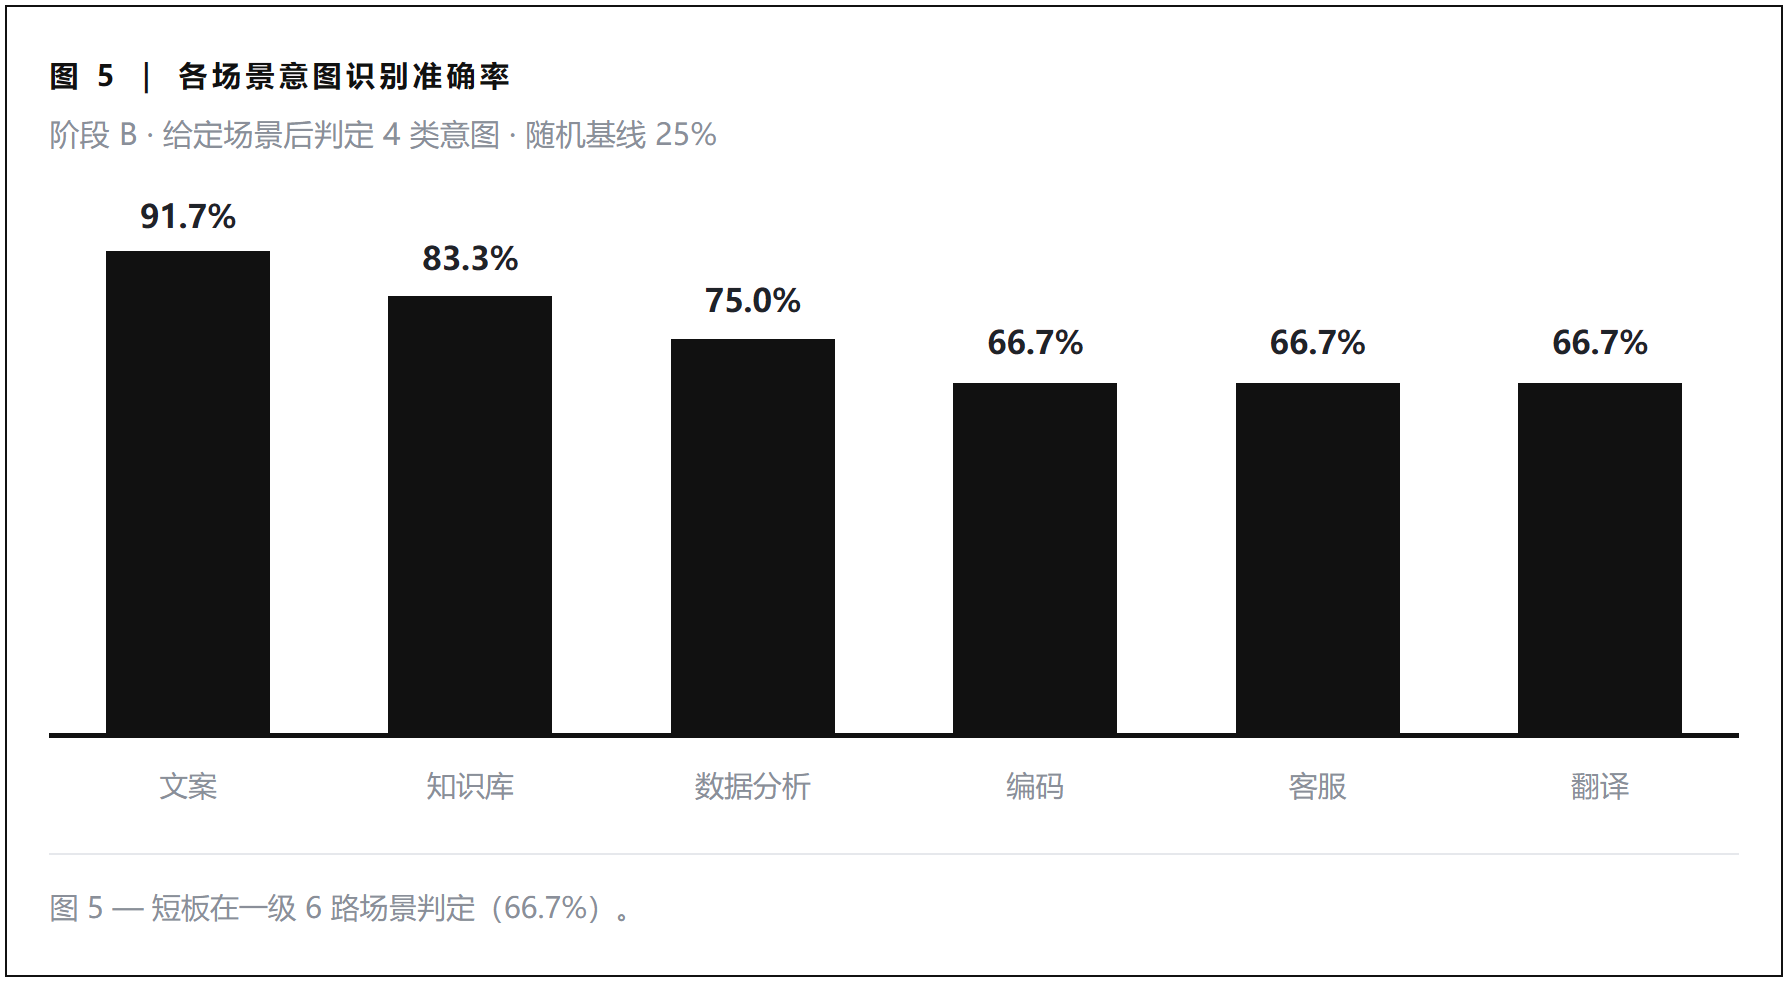
随机基线:4 路 25%、24 路 4.2%。给定场景的 4 路意图识别提升+39 个百分点,端到端 24 路接近翻倍。
各场景的意图识别准确率(阶段 B):
| 场景 | 文案 | 知识库 | 数据分析 | 编码 | 客服 | 翻译 |
|---|---|---|---|---|---|---|
| 准确率 | 91.7% | 83.3% | 75.0% | 66.7% | 66.7% | 66.7% |
当前短板是一级「6 路场景」判定(66.7%),它会偶尔把请求误判为编码场景——这也是下一步优化的重点。
06 Laya 本地识别 vs 原始 LLM 判断
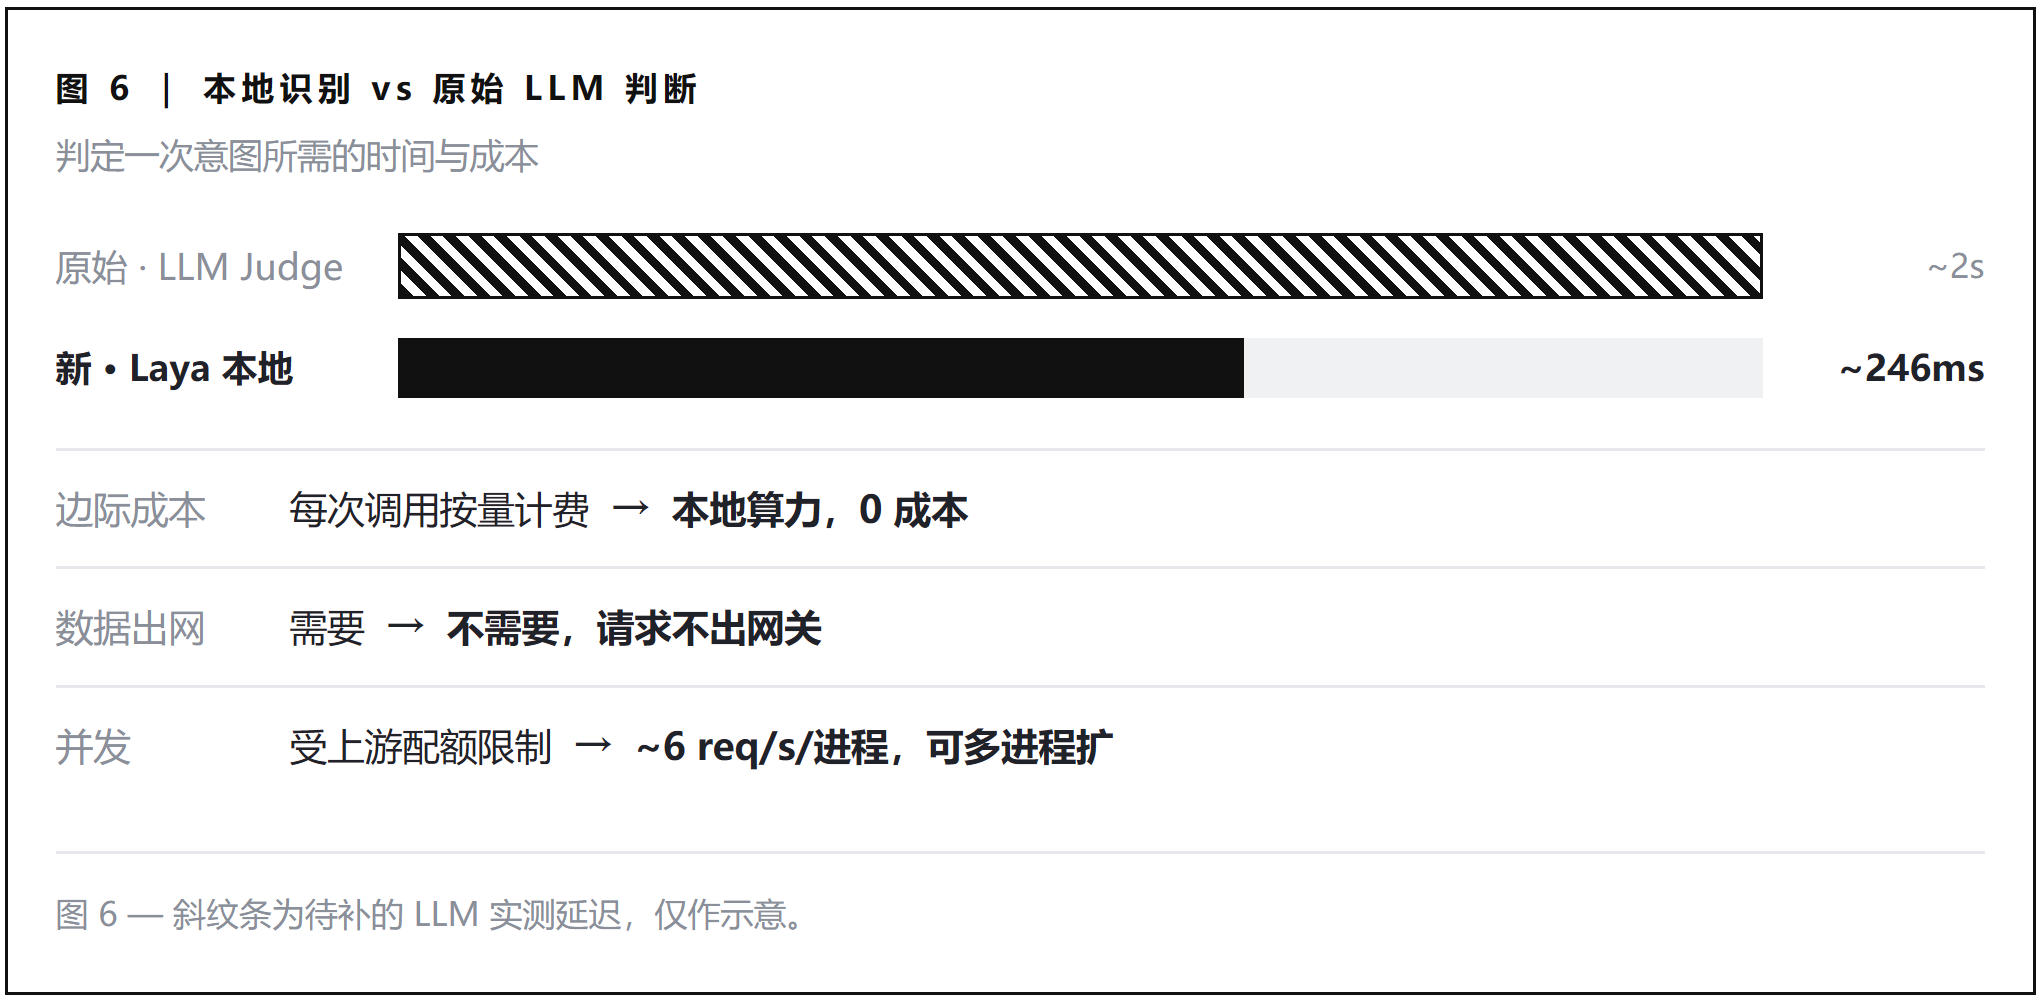
把「用本地小模型做意图识别」与「每次调用 LLM 判断」放在一起看,提升不只是快——更是把一次外部依赖变成了网关的内生能力:
| 维度 | 原始方案:LLM Judge | 新方案:Laya 本地意图识别 |
|---|---|---|
| 判定方式 | 调用一次 LLM chat | 本地一次前向,无生成 |
| 典型延迟 | ~2s(GPU) | ~246ms(CPU · int8) |
| 并发 | 受上游配额与速率限制 | ~6 req/s/进程,可多进程扩 |
| 边际成本 | 每次调用按量计费 | 0(本地算力) |
| 数据出网 | 需要 | 不需要,请求不出网关 |
| 准确率 | 语义轴 4 路85.0%/ 端到端67.3% | 语义轴 4 路75.0%/ 端到端48.6% |
| 兜底 | 即判定本身 | 低置信回退到 LLM Judge |
这里必须诚实说明:在纯准确率上,LLM Judge 仍然更高。
但对私有化场景而言,这是一道取舍题——用约 10–19 个百分点的判定精度,换回零出网、零边际成本、可预测的 246ms、以及不依赖上游配额的稳定性;而精度上的差距,由"低置信回退 LLM Judge"的机制补上。
快,由本地模型负责;稳,由 LLM 兜底。
07 落地形态
在 AMAX AI Gateway 私有化部署里里,意图识别最终长这样:
请求进入
用户 Prompt
快路径 · ~250ms CPU
Laya int8 本地分类
高置信
直接命中专家 → 路由
低置信 / 失败
LLM Judge 兜底
分类法采用「6 业务场景 × 4 语义意图」,两级都是不超过 6 个选项的判断,信息全部放进"问题"里;
置信度取本地模型的真实概率,可用于决定要不要回退;
整个链路跑在企业内网,敏感数据在网关层完成脱敏后再分发,全链路日志留存,可审计、可追溯。
它不是一个独立功能,而是 AMAX AI Gateway「安全治理 + 智能调度 + 配额管理 + 算力协同」四位一体管控体系里的调度内核:上层承接 70+ 主流大模型的统一接入,下层对接本地私有化算力与公有云服务的混合调度——默认本地优先处理敏感业务,高峰时段弹性调用云端算力扩容。
08 局限与下一步
·以上为内部 PoC 数据,样本为72 条合成中文语料,绝对准确率偏乐观;相对结论(语义轴优于档位轴)稳健。
·目标很清晰:让绝大多数请求在本地几十毫秒内完成意图识别,把 LLM 留给真正需要它的少数。
回到开头那个问题——这句话,该交给哪个模型?
在 AMAX AI Gateway 里,答案不再是一次额外的 LLM 调用,而是网关自己的一次内生判断:
快,由本地模型负责;
稳,由 LLM 兜底;而数据
始终留在这家企业自己的内网里。
审核编辑 黄宇